Tajiri
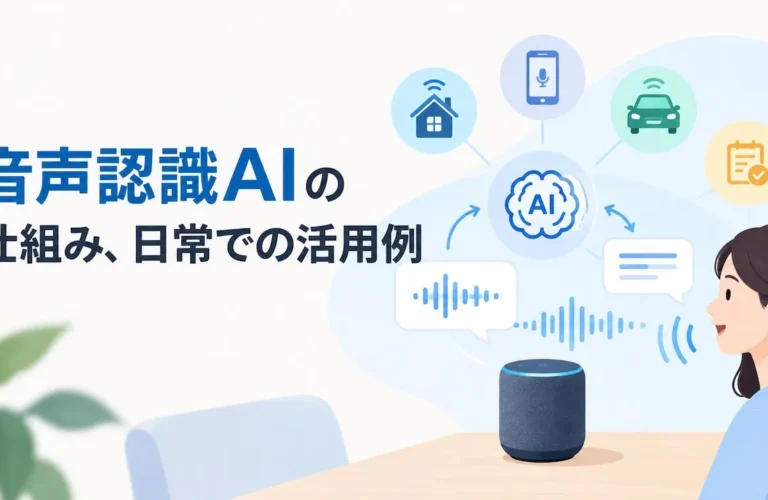
音声認識AIとは、人間が話した言葉をAIがリアルタイムで解析し、音声テキスト変換を行う技術です。Siri・Google アシスタント・Amazon Alexa・Whisperなど、すでに日常生活のあらゆる場面に溶け込んでいます。議事録作成が面倒・入力が楽になりたい・仕事が速くなる方法を探している方に向けて、音声認識AIの仕組みを技術的にわかりやすく解説し、スマートフォン・スマートスピーカー・自動車・議事録自動作成・医療カルテ・コールセンターまで具体的な活用例を網羅します。おすすめのビジネス活用ツールの比較、メリット・デメリット、音声認識 精度の改善方法も解説します。
音声認識AIとは何か
音声認識AIとは、ASR(Automatic Speech Recognition:自動音声認識)とも呼ばれ、ディープラーニングを活用して音声を高精度にテキストへ変換する技術です。音声認識 仕組みの理解が進むと、「なぜ聞き取ってくれない場面があるのか」という疑問への答えも見えてきます。従来の音声認識と区別して「AI」と呼ばれるのは、大量の音声データを学習することで発音・アクセント・周囲の雑音への対応力が飛躍的に向上したためです。話者適応(特定の話者の声を学習して精度を上げる技術)も現代のAI音声認識の重要な機能です。
株式会社グローバルインフォメーションの調査によると、音声認識・言語認識技術関連サービスの市場規模は急速に拡大しており、スマートフォンやスマートスピーカーへの標準搭載が普及の最大の要因です。日常生活でAI音声認識と接触していることを意識しないユーザーが増えているほど、技術の浸透度が高まっています。
音声認識AIと従来の音声認識の違い
| 比較項目 | 従来の音声認識 | AI音声認識(ASR) |
|---|---|---|
| 学習方法 | ルールベース・統計的手法 | ディープラーニングによる大量データ学習 |
| 雑音への対応 | 弱い(静かな環境前提) | 強い(騒音下でも高精度) |
| 話者への対応 | 特定話者のみ | 不特定多数・方言・アクセント対応可能 |
| 認識精度 | 70〜85%程度 | 静音環境でほぼ100%に達するケースあり |
| 多言語対応 | 困難 | 100言語以上に対応するモデルも存在 |
音声認識AIの仕組み:4ステップでわかりやすく解説
音声認識AIは「音声入力→前処理→モデル解析→テキスト出力」という4つのステップで動作します。各ステップで行われていることを順に解説します。
ステップ1:音声の入力と前処理(特徴量抽出)
マイクから入力された音声波形を、コンピュータが処理できる数値データに変換します。この工程では、MFCC(メル周波数ケプストラム係数)などの手法を使って音声の特徴量を抽出します。同時に、ノイズキャンセリング処理が行われ、環境音や背景音を除去します。音声の振動をデジタル信号に変換するこの段階の精度が、後続の認識精度を大きく左右します。
ステップ2:音響モデルによる音素解析
抽出した音声の特徴量を、音の最小単位である「音素(フォネーム)」に分解します。日本語には母音5種・子音など約25の音素があります。音響モデルは、入力された音声データが「どの音素に最も近いか」を確率的に判定します。現在はDNN(深層ニューラルネットワーク)を使ったDNN-HMMモデルが主流で、さらに新しいEnd-to-Endモデルが主流になりつつあります。
ステップ3:言語モデルによる単語・文章の生成
音素の並びをもとに、言語モデルが最も自然な単語・文章を推定します。言語モデルは「この文脈でこの音素の組み合わせが意味する単語は何か」を確率的に判断します。日本語では「橋」と「箸」のような同音異義語の判別が難しく、言語モデルの性能が認識精度を決定的に左右します。文脈を理解するTransformerベースのモデルが登場してから、この工程の精度が大幅に上がっています。
ステップ4:テキスト出力と後処理
認識デコーダが最終的なテキストを出力します。文字起こしではそのままテキストとして提供され、音声アシスタントではこのテキストをもとに自然言語処理(NLP)が動いてAIが適切な返答や操作を実行します。生成AIと組み合わせることで、出力されたテキストの要約・分類・翻訳まで一気に自動化できます。
音声認識AIの技術モデルの種類
音声認識AIには世代ごとに異なる技術モデルが存在し、現在はTransformerベースのEnd-to-Endモデルが主流になっています。それぞれの特徴を把握することで、用途に合ったツール選定がしやすくなります。
| モデル種類 | 特徴 | 代表的なサービス |
|---|---|---|
| HMM(隠れマルコフモデル) | 従来型。統計的手法で音素を推定。精度に限界がある | 初期の音声認識システム全般 |
| DNN-HMMモデル | HMMにDNNを組み合わせ精度を大幅向上。長らく主流だった | Google Cloud Speech(旧世代)、AmiVoice一部 |
| End-to-Endモデル | 音声から直接テキストを出力。中間処理が不要で高精度・高速 | OpenAI Whisper、Google Chirp 3 |
| Transformerベースモデル | 文脈全体を参照して認識精度を最大化。最新世代 | Whisper large-v3、Azure Speech Service |
Google Cloudは最新世代の多言語ASRモデルとしてChirp 3を提供しており、Transformerアーキテクチャの影響を受けた音声認識が広がっています。OpenAIのWhisperは68万時間分の多言語音声データで学習しており、静かな環境下でほぼ100%の文字起こし精度を発揮します。
日常での音声認識AI活用例
音声認識AIはすでに日常生活のあらゆる場面に組み込まれており、意識せずに使っているケースが大半です。代表的な活用シーンを具体的に解説します。
スマートスピーカー(Amazon Alexa・Google Nest・Apple HomePod)
「アレクサ、今日の天気は?」という一声で、検索・音楽再生・家電操作・ショッピングが完結します。Amazon Echo(Alexa)・Google Nest(Google アシスタント)・Apple HomePod(Siri)はいずれも常時音声認識を行うウェイクワード検知機能を搭載しています。ウェイクワード(「アレクサ」「ねえGoogle」「Hey Siri」)を聞き取った瞬間に本格的な音声認識処理が始まり、クラウドのASRエンジンで解析して返答します。
スマートフォンの音声入力・Siri・Google アシスタント
iPhoneのSiriとAndroidのGoogle アシスタントは、メッセージ送信・電話発信・アプリ起動・ナビ操作をハンズフリーで実行できます。移動中・料理中・運転中など、手が使えない場面での入力手段として定着しています。日本語の音声入力精度は両プラットフォームとも高水準に達しており、メールや検索クエリをほぼミスなく入力できます。
カーナビ・車載音声認識
自動車のカーナビシステムに搭載された音声認識AIは、目的地設定・空調調整・電話発信をドライバーがハンドルから手を離さずに操作できます。トヨタのクルマのAI音声アシスタント「エージェント」・日産のインテリジェントアシスタントなど、国産メーカーが独自の日本語対応音声認識システムを搭載しています。運転中の安全性向上に直結する用途として、音声認識の精度向上が優先的に開発されています。
スマートテレビ・家電の音声操作
音声認識を搭載したスマートテレビは「チャンネルを変えて」「音量を上げて」という自然な発話でリモコン操作が不要になります。Panasonic・Sony・LGなど主要メーカーがGoogle アシスタントまたは独自音声認識エンジンを搭載しており、日本語での操作精度も実用水準に達しています。エアコン・照明・ロボット掃除機との連携でスマートホーム化が進んでいます。
語学学習アプリへの活用
Duolingoなど語学学習アプリの発音練習機能では、音声認識AIが学習者の発音を解析してリアルタイムで正確さのスコアを返します。AI音声認識が発音のフィードバックを即座に提供することで、講師なしで発音矯正が可能になっています。英語学習者が正しい発音かどうかを確認できる機能として、音声認識の活用が語学教育に定着しています。
ビジネスでの音声認識AI活用例
ビジネス領域での音声認識AI活用は、業務効率化・業務精度の向上・顧客満足度の向上という3つの効果をもたらします。導入が進んでいる主要業種と用途を解説します。
議事録・会議の自動文字起こし
会議音声をリアルタイムまたは録音後に自動文字起こしし、議事録を自動生成する用途が最も普及しています。Notta・Otter.ai・Microsoft Teams Premium・Google Meet文字起こし機能など、会議ツールへの統合が進んでいます。話者分離(誰が話しているかを識別する機能)を持つサービスでは、「Aさん:」「Bさん:」と話者ごとにテキストが自動整理されます。生成AIと組み合わせることで、テキストから要約・アクションアイテムの抽出・次回議題の整理まで一気に自動化できます。
コールセンター業務の効率化
コールセンターでは音声認識AIの活用が最も進んでいる業種のひとつで、通話内容のリアルタイム文字起こし・品質分析・応対マニュアルの自動提示に使われています。オペレーターが顧客と話している間に、AIが通話内容を解析してオペレーターの画面に適切な回答候補や関連情報を表示するリアルタイムアシスト機能が実装されています。通話後の品質評価・感情分析・クレーム傾向の分析にも音声認識データが活用されています。
医療・介護現場でのカルテ作成
医師が診察しながら話した内容を音声認識AIがリアルタイムで文字起こしし、電子カルテへの入力を自動化する仕組みが医療機関に導入されています。AmiVoice(アドバンスト・メディア社)は医療・介護・法律など専門用語に特化した日本語音声認識エンジンとして、全国の医療機関に採用されています。診察中のキーボード入力ゼロを実現し、医師が患者との対話に集中できる環境を作ります。
製造業・現場作業での音声入力
工場や物流倉庫では、作業者が両手を使いながら音声で検査結果・作業記録を入力するハンズフリー音声入力システムが普及しています。ハンズフリーで操作できる点が製造現場との相性が良く、作業ミスの削減と記録の正確性向上に貢献しています。ヘルメットや作業着に付けたマイクから音声を入力し、クラウドのASRエンジンがリアルタイムで処理します。
多言語対応・インバウンド対応
外国人観光客との会話支援に、音声認識と機械翻訳を組み合わせたリアルタイム音声翻訳アプリが活用されています。観光施設・ホテル・病院での窓口対応に、音声認識→翻訳→音声合成という一連の処理を行うシステムが導入されています。Google翻訳・DeepL・Papago(韓国語)などのアプリが旅行者と接客スタッフの間の言語バリアを取り除いています。
主要な音声認識AIツール比較
用途に合った音声認識AIツールを選ぶことが、精度とコストを最適化する最重要ポイントです。主要ツールを特徴・精度・対応言語・料金で比較します。
| ツール名 | 提供元 | 日本語精度 | 料金 | 向いている用途 |
|---|---|---|---|---|
| Whisper(large-v3) | OpenAI | 高い(静音環境でほぼ100%) | オープンソース(無料)/ API有料 | 汎用文字起こし・多言語対応・個人利用 |
| AmiVoice | アドバンスト・メディア | 最高(専門用語特化) | 月額制(法人向け) | 医療・介護・法律・コールセンター |
| Google Cloud Speech-to-Text(Chirp 3) | 高い(多言語最強クラス) | 従量課金(1分あたり約0.006ドル〜) | 大量処理・API連携・多言語 | |
| Azure Speech Service | Microsoft | 高い | 従量課金(1時間あたり約1ドル〜) | 企業システム統合・リアルタイム処理 |
| Notta | Notta Inc. | 高い | 無料プランあり / Pro 月額1,900円〜 | 議事録・Zoom/Teams連携・個人〜中小企業 |
| Apple Siri / Google アシスタント | Apple / Google | 高い | 無料(デバイス標準搭載) | 日常のスマートフォン音声操作 |
Whisper vs AmiVoice:どちらを選ぶべきか
汎用的な文字起こしとコストパフォーマンスを重視するならWhisper、専門用語が多い医療・法律・コールセンター用途ならAmiVoiceが適しています。Whisperは医療用語・人名・固有名詞の認識ミスが起きやすい一方、AmiVoiceは専門用語の追加学習と話者分離機能が標準搭載です。単純な文字起こしであればWhisperのコストパフォーマンスは非常に魅力的で、ビジネス用途にはGoogle CloudやAmiVoiceのカスタマイズ機能の価値が高くなります。
音声認識AIの限界と精度を上げる方法
音声認識AIは高性能になっていますが、万能ではありません。以下の課題を把握した上で運用設計することで、精度の低さによる業務リスクを下げられます。
日本語特有の認識精度の課題
- 同音異義語の誤認識: 「橋」と「箸」、「機械」と「機会」など、日本語には同じ発音で異なる意味を持つ単語が多く、文脈理解が認識精度を大きく左右します。
- アクセントと方言: 日本語は地域によってアクセントが大きく異なります。標準語以外の方言・なまりに対する認識精度は、英語に比べて学習データが少ないため精度が落ちやすい傾向があります。
- 専門用語・固有名詞: 医療用語・法律用語・企業名・人名など、学習データに含まれていない専門用語の認識精度は低くなります。AmiVoiceのようなカスタム辞書機能を持つツールを選ぶか、専門用語リストを追加学習させる設定が有効です。
- 複数話者の混在: 複数人が同時に話す会議では、誰が何を話しているかを識別する話者分離が必要です。話者分離機能を持つサービスを選ぶことで精度が大幅に改善します。
音声認識精度を上げる実践的な方法
- マイクの品質を上げる: ノイズキャンセリング機能付きのマイクまたはヘッドセットを使うだけで認識精度が10〜20%向上するケースがあります。
- 静かな環境で話す: 55dBを超える環境音は認識精度を大きく落とします。会議室や静かなオフィスでの利用が基本です。
- 明瞭にはっきり話す: 早口・小声・語尾が消える発話は認識精度を下げます。句読点を意識したゆっくりとした発話が効果的です。
- 専門用語をカスタム辞書に登録する: 業種固有の用語・人名・製品名をカスタム辞書に追加することで、専門用語の認識精度を大幅に改善できます。
音声認識AIと生成AIの統合が変える未来
音声認識AIと生成AI(LLM)の統合が進み、「話すだけで仕事が完了する」ワークフローが現実になりつつあります。音声認識でテキスト化し、生成AIが要約・分類・返信・翻訳を自動実行するパイプラインは、すでにコールセンター・医療・製造業で実装が始まっています。
パーソルビジネスプロセスデザインのような企業では、音声認識結果を生成AIと組み合わせることで、要約・分類・次のアクションの提案まで一括自動化するシステムを構築しています。ただし、生成AIが元の発言にない内容を出力するハルシネーションのリスクがあるため、重要な情報は人が確認する運用ルールが必要です。
音声認識AIを含むAI技術の日常活用をさらに詳しく知りたい方は、日常に溶け込むAI活用術も参考にしてください。AI技術の最新情報はJapaneseAI.orgで継続的に発信しています。
よくある質問(FAQ)
音声認識AIとは何ですか?
AIが音声をリアルタイムで解析してテキストに変換する技術で、ASR(自動音声認識)とも呼ばれます。
音声認識AIの認識精度はどのくらいですか?
Whisperは静音環境でほぼ100%に達し、55dB程度の生活騒音下でも高精度を維持します。
無料で使える音声認識AIはありますか?
OpenAI Whisper・Google音声入力・Apple Siriはいずれも無料で日本語に対応しています。
日本語の音声認識精度が低い理由は何ですか?
英語中心の学習データでは日本語の同音異義語・アクセント・連続音節の区切り処理が苦手になります。
音声認識AIをビジネスに導入するには何が必要ですか?
目的に合ったASRサービスの選定と、専門用語のカスタム辞書登録または話者適応設定が必要です。